Todos los libros del mundo
Para construir su IA, Anthropic descargó más de siete millones de libros piratas, y después pagó 1,500 millones de dólares para cerrar esas demandas. También compró millones de libros usados, los desarmó y los escaneó. Un juez dijo que esa parte era legal, porque el papel se destruía y los escaneos se quedaban dentro de la empresa. Una biblioteca que Aaron Swartz ayudó a crear escaneó libros para prestarlos al público, y perdió. ¿Por qué una empresa puede copiar libros para una máquina, y una biblioteca no puede hacerlo para la gente?
Traducción del original en inglés. Las citas de documentos judiciales y de otras fuentes son traducciones del autor; los originales están enlazados en las notas.
Un libro, desarmado
Empecemos con un solo libro. Uno de bolsillo, comprado de segunda mano. Primero le arrancan la encuadernación. Después le recortan las páginas para que se separen limpias. Escanean cada página, tapas incluidas, hasta que el libro existe como un PDF: fotos de cada página, con una capa de texto debajo que una computadora puede leer. Después, el papel se tira.1
Esto ocurrió millones de veces. La empresa que lo pagaba era Anthropic, la que hace el modelo de IA Claude, y los escaneos iban a lo que sus empleados llamaban una biblioteca de investigación. Entre los libros que pasaron por ese proceso, según un tribunal federal, había libros de los tres autores que después demandarían a la empresa: Andrea Bartz, Charles Graeber y Kirk Wallace Johnson.2
Y ni siquiera fue la primera forma en que Anthropic consiguió libros. Años antes de empezar a comprarlos, había descargado gratis de internet más de siete millones de copias piratas. Ese atajo terminaría costándole 1,500 millones de dólares.
Así que aquí hay una pregunta obvia. ¿Por qué una empresa que ya tenía millones de libros piratas gratis saldría a comprarlos, solo para destruirlos?
La respuesta apareció en una sentencia judicial, y tiene menos que ver con libros que con contar. Pero para entenderla, primero hay que saber de dónde salieron los libros. Y esa historia empieza en otra empresa.
De dónde salieron los libros
En 2020, OpenAI, la empresa que después haría ChatGPT, publicó un paper en el que presentaba GPT-3, un modelo temprano de la línea que llevó a ChatGPT. Entre los materiales con los que se entrenó, el paper mencionaba “dos corpus de libros basados en internet”, llamados Books1 y Books2. Juntos eran cerca del 16 por ciento de la mezcla de entrenamiento. El paper no decía nada más sobre de dónde venían esos libros.3
Cinco años después, una jueza federal completó el dato. Es “indiscutido”, escribió, que en 2018 un empleado de OpenAI descargó libros piratas de Library Genesis, conocida como LibGen. LibGen es la mayor de las llamadas bibliotecas en la sombra: sitios web que comparten gratis libros y artículos académicos piratas. Según los autores que hoy demandan a OpenAI, las colecciones se llamaban originalmente LibGen1 y LibGen2, y solo después se renombraron Books1 y Books2. Según testimonios en el caso, se usaron para entrenar GPT-3 y GPT-3.5.4
Mira quién firmó ese paper de 2020. Entre sus autores estaban Dario Amodei y Ben Mann. Para 2021, los dos habían dejado OpenAI y cofundado una nueva empresa. Se llamaba Anthropic.5
Dentro de OpenAI sabían que la fuente era un problema. En mensajes internos citados por los abogados de los autores, en un escrito que se hizo público este mes, Amodei, todavía en OpenAI, escribió que “como conjunto de entrenamiento, [LibGen es] un poco más turbio”. Otro investigador, Sam McCandlish, que también terminaría en Anthropic, dijo que le “preocupaba la imagen”, e imaginaba el titular “openai usa datos con copyright de un sitio ruso turbio”.6
En Anthropic, el mismo atajo volvió a aparecer. Según el resumen de la evidencia que hizo el juez en el caso de Anthropic, a comienzos de 2021 Ben Mann descargó Books3, una colección de 196,640 libros que él sabía que se había armado con copias piratas. Ese junio descargó al menos cinco millones más de LibGen. En julio de 2022 la empresa sumó al menos dos millones de otra biblioteca en la sombra, Pirate Library Mirror. En total, más de siete millones de copias piratas, guardadas en una biblioteca central de lo que los documentos internos llamaban “todos los libros del mundo”, para conservarlas “para siempre”.7
No tenía por qué ser así. Anthropic “tenía muchos lugares” donde comprar libros, escribió el juez, pero prefirió evitar lo que Amodei, ya como director ejecutivo, llamó un “lío legal, práctico y de negocios”.8
Mientras tanto, en OpenAI, los libros desaparecían sin ruido. En junio de 2022, un directivo, Bob McGrew, escribió en un canal de Slack: “Con lo mucho que OpenAI está en las noticias, este es el momento de extirpar LibGen de nuestros sistemas”. El canal se había llamado originalmente “excise-libgen” (“extirpar libgen”). En algún momento pasó a llamarse “project-clear”. Hacia mediados de 2022, alrededor de un año antes de que los autores empezaran a demandar, OpenAI borró Books1 y Books2. Primero le dijo al tribunal que el motivo era que ya no se usaban. Después retiró esa explicación, y luego dijo que los motivos eran parte de conversaciones confidenciales con sus abogados. En febrero de 2026, un juez aceptó que esas conversaciones siguieran siendo privadas, así que quizá nunca sepamos exactamente por qué.9
¿Por qué destruir un libro que compraste?
Para 2024, Anthropic quería una forma más limpia de conseguir libros. En febrero contrató a Tom Turvey, que había sido jefe de alianzas de Google Books, el proyecto de Google para escanear los libros del mundo. Su trabajo era conseguir “todos los libros del mundo” con el menor lío posible. Turvey mandó un correo o dos a grandes editoriales para preguntar por pagar permisos y usar sus libros para entrenar IA. Después, en palabras del juez, “dejó que esas conversaciones se marchitaran”. En cambio, su equipo empezó a comprar libros impresos al por mayor a distribuidores y tiendas, muchos de ellos usados.10
Dentro de la empresa, esto se convirtió en Project Panama. Un documento de planificación que salió a la luz durante la demanda, y que The Washington Post reportó primero en enero de 2026, lo describía como “nuestro esfuerzo por escanear destructivamente todos los libros del mundo”. Y añadía: “No queremos que se sepa que estamos trabajando en esto”.11
En junio de 2025, William Alsup, un juez federal de San Francisco, resolvió todo esto. Su decisión importa porque separa tres cosas que los titulares mezclaban una y otra vez.
Primero, un poco de contexto. La ley de derechos de autor de Estados Unidos, la que decide quién puede copiar el trabajo de otro, tiene una válvula de escape llamada fair use, o uso legítimo. Permite usar la obra de otro sin pedir permiso, siempre que la conviertas en algo nuevo: una reseña que cita una novela, una parodia, un buscador que indexa todos los libros. Los tribunales llaman “transformador” a ese tipo de uso.
La primera cuestión era el entrenamiento, es decir, darle los libros a un modelo de IA. El juez decidió que eso era uso legítimo. El modelo no te vende el libro, razonó: aprende de él, “como cualquier lector que aspira a ser escritor”, no “para adelantarse y replicar o suplantar” los originales, “sino para doblar una esquina difícil y crear algo distinto”. Lo llamó transformador, “espectacularmente”.
La segunda era la biblioteca pirata. Descargar siete millones de libros piratas para quedárselos, decidió el juez, no era uso legítimo, y mandó esa parte a juicio. Piratear libros que se podían comprar, escribió, “es inherente e irremediablemente infractor”.
La tercera eran los libros escaneados, y aquí está la respuesta a nuestra pregunta inicial. Anthropic había pagado cada ejemplar. Cuando compras un libro, la ley te deja hacer casi cualquier cosa con él salvo hacer más copias, y un escaneo es una copia. Pero Anthropic destruía cada libro de papel al escanearlo, y guardaba la versión digital dentro de la empresa. “El original impreso fue destruido”, escribió Alsup. “Uno reemplazó al otro. Y no hay evidencia de que la nueva copia digital se mostrara, compartiera o vendiera fuera de la empresa.” Es decir, el número de copias en el mundo no aumentó. El libro solo cambió de formato, de papel a archivo. Eso, decidió, también era uso legítimo.12
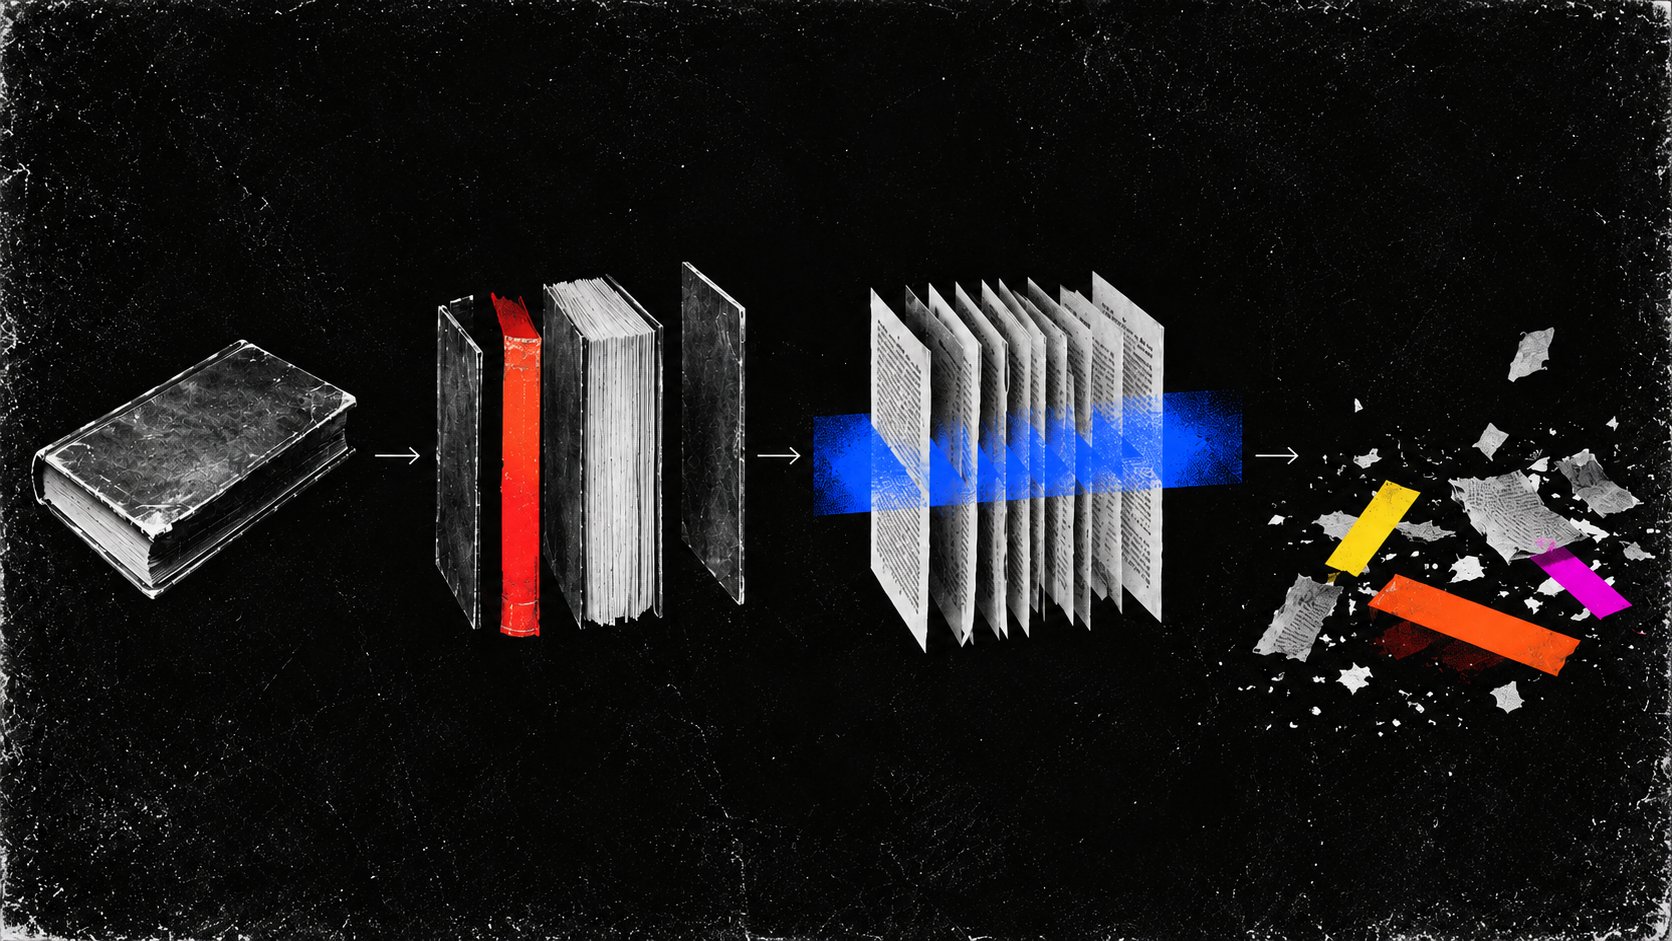
Nada en el expediente dice que Anthropic cortara los libros para ganar este argumento. La razón más probable, y esto es una suposición mía, no del expediente, es que un libro sin lomo se escanea mucho más rápido. Pero en el tribunal, la destrucción hizo el trabajo. Como el papel ya no existía, el escaneo contó como un cambio de formato y no como una nueva copia del libro.
En setiembre de 2025, Anthropic llegó a un acuerdo por la parte de la piratería, es decir, aceptó pagar en lugar de ir a juicio. El precio fue de 1,500 millones de dólares, unos 3,000 dólares por cada uno de aproximadamente medio millón de libros, y se comprometió a borrar los archivos piratas. Fíjate en qué pagó: por cómo consiguió los libros, no por lo que hizo con ellos. El tribunal ya había dicho que lo segundo estaba bien. El acuerdo recibió la aprobación final en julio de 2026.13
Una frase de una audiencia del caso merecía más atención de la que recibió. Ante el juez, el propio abogado de Anthropic dijo: “No puedes simplemente bendecirte a ti mismo diciendo que tienes un propósito de investigación y, por lo tanto, ir y llevarte cualquier libro de texto que quieras. Eso destruiría el mercado editorial académico si fuera así”. El juez coincidió en que eso resumía el problema, y lo usó en contra de la empresa.14
La otra biblioteca
En esta historia hubo otra biblioteca de libros escaneados, y perdió.
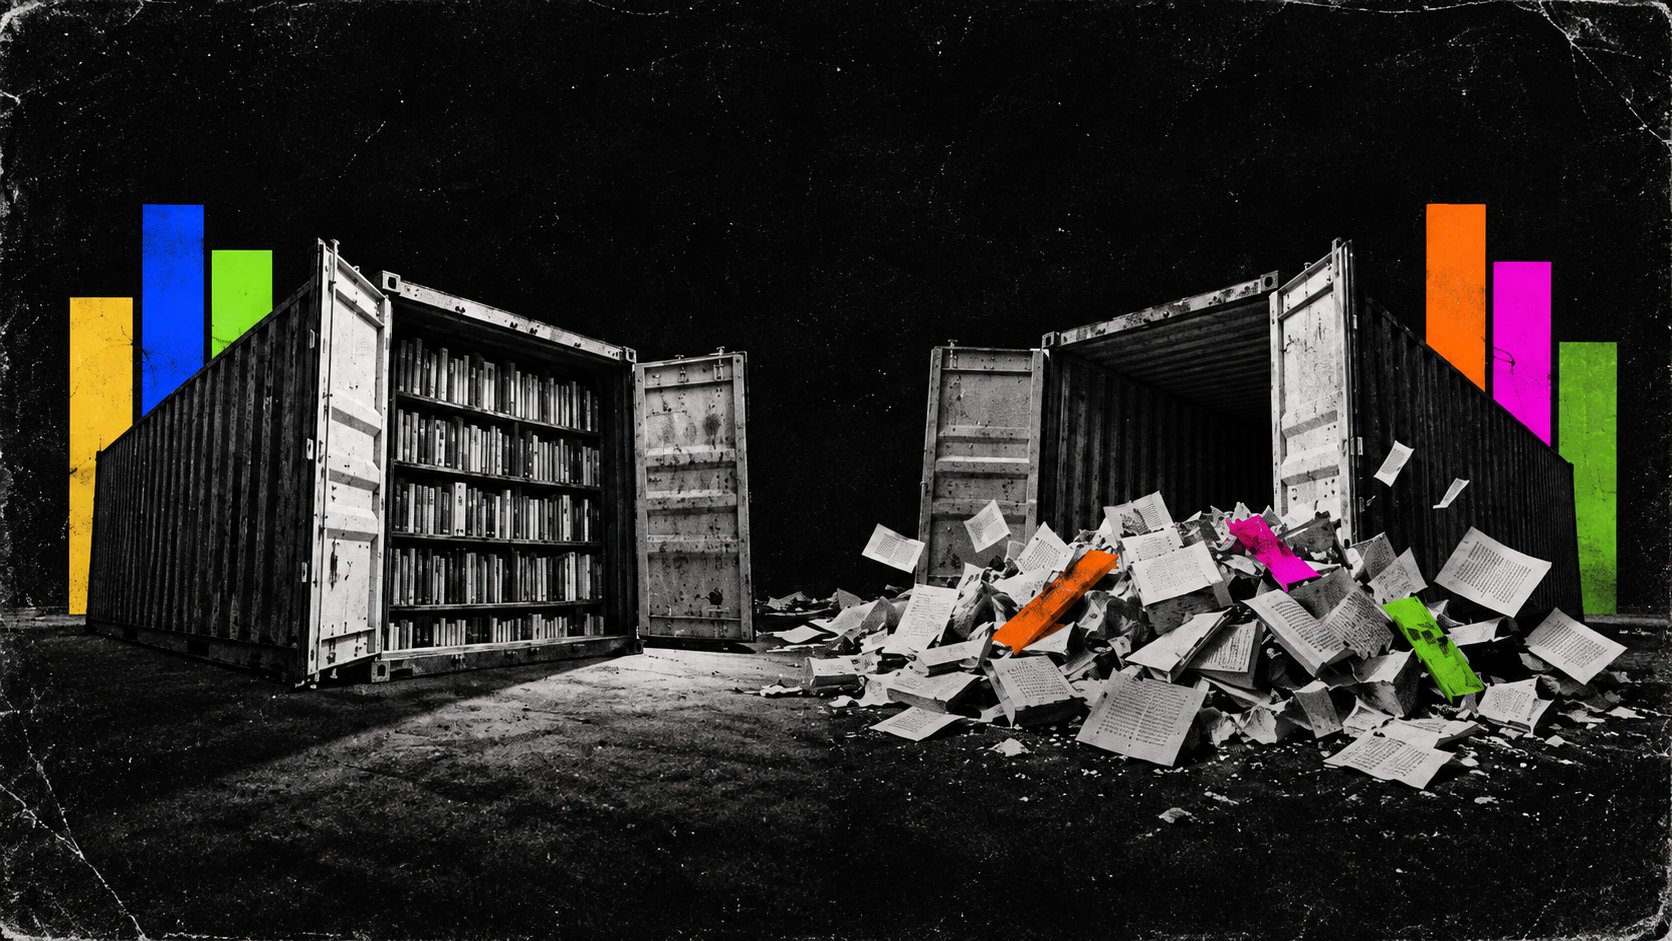
En 2007, un joven programador llamado Aaron Swartz ayudó a lanzar Open Library, un proyecto del Internet Archive, la organización sin fines de lucro conocida por la Wayback Machine. Su objetivo era “una página web para cada libro que se haya publicado”. En 2011 el Archive empezó a prestar libros escaneados a través de ella, y lo hacía con cuidado. El Archive y un socio sin fines de lucro adquirían libros impresos, comprados o donados, sobre todo a Better World Books, una tienda de libros usados. Los escaneaban y prestaban una sola copia digital a la vez por cada ejemplar físico que tenían, como una biblioteca que presta un libro. Los libros de papel no se destruían. Según el tribunal, “se colocaban en contenedores de envío y se mantenían fuera de circulación después del escaneo”.15
Las editoriales demandaron en 2020. En setiembre de 2024, nueve meses antes de la sentencia del juez Alsup, un tribunal federal de apelaciones de Nueva York decidió que el préstamo no era uso legítimo. Mira lo que señaló como el problema: “Los libros digitales [del Archive] cumplen exactamente el mismo propósito que los originales: poner las obras de los autores a disposición para ser leídas”.16 Para el tribunal, el problema era que las copias hacían exactamente lo que hacen los libros. Dejaban leer a la gente.
Las dos bibliotecas se construyeron de forma parecida. Las dos compraron libros impresos al por mayor y, si los reportes de prensa son correctos, a por lo menos un mismo vendedor. Las dos los escanearon. La que conservó su papel y dejó que el público leyera los escaneos perdió. La que tiró su papel y guardó los escaneos dentro de la empresa, donde los leían sus modelos de IA, ganó. Fueron tribunales distintos, con hechos distintos, y ninguna sentencia menciona a la otra. Pero leídas juntas trazan una línea que ninguna traza sola. Una copia que la gente puede leer ocupa el lugar del libro. Una copia que lee en privado una máquina cuenta como algo nuevo.
De dónde viene esa línea
La línea no apareció de la nada. Sus raíces llegan hasta Google.
En los años 2000, Google escaneó millones de libros de bibliotecas universitarias para Google Books, y los autores lo demandaron. En 2015, el mismo tribunal de apelaciones de Nueva York decidió que Google Books, un buscador de libros que solo muestra fragmentos breves, era uso legítimo. El juez Alsup se apoyó en esa decisión cuando dijo que convertir los libros de papel de Anthropic en archivos estaba bien. Y recuerda a quién contrató Anthropic para conseguir todos los libros del mundo: al exjefe de alianzas del proyecto de escaneo de Google.17
Alguien lo vio venir. En julio de 2008, mientras Google seguía escaneando, apareció en internet un texto breve firmado por Aaron Swartz, el mismo programador que había ayudado a crear Open Library, con el título “Guerilla Open Access Manifesto” (Manifiesto de la guerrilla por el acceso abierto). En una lista de quejas sobre quién controla el conocimiento, preguntaba:
¿Escanear bibliotecas enteras pero solo dejar que las lea la gente de Google?
Dieciocho años después, el modelo del que se quejaba, bibliotecas enteras escaneadas y legibles por la empresa dueña de los escaneos, es el modelo que la ley aprobó. Anthropic solo agregó un paso que Google nunca necesitó: cuando termines, tira el papel.18
La historia de Aaron, y por qué el gobierno de Estados Unidos lo procesó por descargar artículos académicos, es demasiado grande para contarla en un párrafo. Merece su propio ensayo. Será el próximo.
Lo que todavía no se decide
El caso de Anthropic está cerrado. El de OpenAI no.
Este mes, las dos partes de la demanda de los autores contra OpenAI y Microsoft le pidieron al juez Sidney Stein, en Nueva York, que falle a su favor sin llegar a juicio. Los autores sostienen que OpenAI “construyó los cimientos de su negocio sobre una piratería masiva”, y que sus modelos “representan una amenaza existencial para quienes escriben y publican libros”. OpenAI sostiene que entrenar con libros es uso legítimo, y que sus modelos rara vez reproducen los libros de los que aprendieron. Se espera una audiencia a comienzos del próximo año.19
El gobierno de Estados Unidos ya eligió un lado. El 1 de setiembre, el Departamento de Justicia le pidió al tribunal que declarara que entrenar modelos de IA con textos protegidos es uso legítimo, y citó al juez Alsup: “transformador, espectacularmente”. Basó su posición en parte en la seguridad nacional y en la competencia con “adversarios extranjeros”. Pero la presentación es cuidadosa. Solo trata el entrenamiento, y no dice nada sobre cómo se consiguieron los libros.20
En ese vacío está hoy la verdadera pelea. Todos parecen dispuestos a aceptar que una IA aprenda de los libros. La pregunta abierta es si una empresa puede construir esa IA con libros que nunca pagó, y quedarse con el beneficio después de borrar las copias. El juez de Anthropic dijo que no, y Anthropic pagó. El juez de OpenAI todavía no lo ha dicho.
El mejor argumento contra este ensayo
El crítico más fuerte de este ensayo diría que estoy haciendo que algo normal parezca siniestro. La línea que trazan los tribunales no tiene nada que ver con adentro y afuera, ni con empresas y bibliotecas. Es la pregunta más antigua del uso legítimo: ¿tu copia reemplaza al original? Los fragmentos de Google no reemplazan un libro. Un modelo de IA entrenado, si funciona como se espera, no te entrega uno. El préstamo del Internet Archive sí, préstamo por préstamo. La misma regla protege a los investigadores que analizan enormes colecciones de textos, y protegería a una biblioteca pública que usara escaneos para búsquedas o investigación en lugar de préstamos. Y lo que hicieron las empresas de IA que más se parece a un robo, tomar copias a las que no tenían derecho, es justamente lo que el tribunal se negó a excusar, a un costo de 1,500 millones de dólares. El sistema, en otras palabras, funcionó.
Casi todo eso es cierto. La prueba es si una copia reemplaza al original, y no tiene nada de siniestro. Anthropic sí pagó.
Pero una regla justa puede tener efectos desiguales. Una empresa que convierte libros en un producto puede ganar dinero con ellos sin entregar nunca una copia, así que pasa la prueba por diseño. Una biblioteca pública solo puede darle a la gente el valor de un libro dejándola leerlo, así que la reprueba por diseño. La regla nunca pregunta quién puede darse el lujo de no compartir. Simplemente lo premia.
El modelo de IA sí le devuelve algo al público, y hay que decirlo con claridad: lo que aprendió de los libros, vendido por suscripción. Si eso cuenta como compartir el conocimiento, o es la forma más eficiente que alguien ha encontrado de no compartirlo es, creo, la verdadera discusión. La ley de derechos de autor no se hizo para resolverla.
Lo que queda
Las copias piratas están desapareciendo. Anthropic se comprometió a borrar sus bibliotecas en la sombra. OpenAI borró Books1 y Books2 antes de que nadie se lo pidiera. Con esos libros se construyeron modelos, y los modelos siguen aquí.
Y luego está el papel. Los libros impresos del Internet Archive están en contenedores de envío, fuera de circulación, para que cada escaneo pueda ocupar el lugar de exactamente un libro, un sistema que un tribunal ya dijo que no bastaba. Los libros impresos de Anthropic ya no existen: se tiraron página por página a medida que se escaneaban. El papel que sobrevivió es el que nadie puede leer. El papel que se destruyó se lee, de la única forma que le queda, cada vez que alguien le hace una pregunta a un modelo entrenado con él.
¿Quién puede copiar el conocimiento? Casi cualquiera, resulta, que pueda comprarlo primero y guardárselo. Lo que queda es la pregunta de 2008, la que termina en signo de interrogación: escanear bibliotecas enteras y solo dejar que las lea la gente de la empresa. Entonces se escribió como un escándalo. Hoy se lee como un resumen justo de la ley.
Footnotes
-
Bartz v. Anthropic PBC, No. C 24-05417 WHA, Order on Fair Use (N.D. Cal., 23 de junio de 2025), pp. 4, 15. ↩
-
Bartz, p. 4, nota 2. ↩
-
Brown et al., “Language Models are Few-Shot Learners” (OpenAI, 2020), sección 2.2 y tabla 2.2. En el original: “two internet-based books corpora”. ↩
-
In re OpenAI, Inc. Copyright Infringement Litigation, No. 25-md-3143, Opinion and Order (S.D.N.Y., 24 de noviembre de 2025) (jueza Wang). ↩
-
La lista de autores del paper incluye a Dario Amodei y Benjamin Mann (arXiv:2005.14165). La sentencia de Bartz, p. 2, identifica a Amodei como “cofounder and chief executive officer” de Anthropic y a Mann como “another Anthropic cofounder”. ↩
-
Memorando de los demandantes en apoyo de su moción de summary judgment parcial, In re OpenAI, No. 25-md-3143, Doc. 1982 (desclasificado el 17 de setiembre de 2026), citado por el Authors Guild. Son pruebas presentadas por los demandantes; OpenAI discute su interpretación. En el original: “as a training set [LibGen is] a bit sketchier”; “worried about optics”; “openai uses copyrighted data from sketchy russian website”. ↩
-
Bartz, pp. 1–3, 19. ↩
-
Bartz, p. 2. En el original: “ha[d] many places from which” y “legal/practice/business slog”. ↩
-
Resumen del Authors Guild del Doc. 1982, arriba (en el original: “Given how much OpenAI is in the news, now is the right time to excise Libgen from our systems”); orden de la jueza Wang, arriba; sobre la orden del juez Stein del 6 de febrero de 2026, ver Sterne Kessler, “Privilege Preserved”. ↩
-
Bartz, pp. 3–4. ↩
-
“Anthropic ‘destructively’ scanned millions of books to build Claude”, The Washington Post, 27 de enero de 2026. ↩
-
Bartz, pp. 13–19. En el original: “The print original was destroyed. One replaced the other.” ↩
-
Authors Guild, “What Authors Need to Know About the Anthropic Settlement”; Authors Guild, “Court Grants Final Approval” (julio de 2026). ↩
-
Bartz, p. 18 (citando la transcripción de la audiencia, p. 53). ↩
-
Open Library, “About”; Hachette Book Group, Inc. v. Internet Archive, No. 23-1260 (2.º Cir., 4 de setiembre de 2024), p. 11. ↩
-
Hachette, p. 24. En el original: “making authors’ works available to read.” ↩
-
Authors Guild v. Google, Inc., 804 F.3d 202 (2.º Cir. 2015); Bartz, p. 15. ↩
-
“Guerilla Open Access Manifesto” (julio de 2008). En el original: “Scanning entire libraries but only allowing the folks at Google to read them?” La revisión del MIT de 2013 señala que Swartz no fue su único autor (informe del MIT, parte II.A.2, nota 13). ↩
-
“Authors Guild, Co-Plaintiffs Seek Summary Judgment in OpenAI Case”, Publishers Weekly, setiembre de 2026; “OpenAI’s ChatGPT Was Built on Concealed ‘Mass Piracy’, Authors Tell Court”, TorrentFreak, setiembre de 2026. ↩
-
Statement of Interest of the United States, In re OpenAI, No. 25-md-3143 (S.D.N.Y., 1 de setiembre de 2026). ↩